
Angular 19 wprowadził potężny nowy hook o nazwie afterRenderEffect, który łączy możliwości effect i afterRender w jedną, wydajną funkcję. Ułatwia to zarządzanie efektami ubocznymi zależnymi od zmian sygnałów oraz zakończenia cyklu renderowania Angulara.
Zanim zagłębimy się w afterRenderEffect, warto krótko przypomnieć podstawowe koncepcje effect i afterRender osobno.
Hook afterRenderEffect został wprowadzony w Angular 19 i łączy funkcjonalność effect oraz afterRender.
effect(() => console.log(this.signalSource()))W tym fragmencie kodu console.log będzie uruchamiany za każdym razem, gdy signalSource zostanie oznaczony jako “dirty”.
Z kolei hook afterRender wywołuje swoją funkcję zwrotną po zakończeniu renderowania widoku i w trakcie każdej detekcji zmian. Jest to kluczowe dla zadań wymagających pełnej aktualizacji DOM.
afterRenderEffect łączy te dwie funkcjonalności. Callback zostanie wykonany zarówno wtedy, gdy zależny sygnał zostanie oznaczony jako “dirty”, jak i po zakończeniu cyklu renderowania. Dzięki temu możemy zastosować optymalizacje wydajnościowe i uniknąć problemów związanych z “layout thrashing”.
W tym artykule przyjrzymy się, jak działa afterRenderEffect, przedstawimy jego praktyczne zastosowania oraz pokażemy, jak może on poprawić wydajność w sytuacjach, gdy musimy pracować z DOM w aplikacjach Angular.
Syntax
Funkcja afterRenderEffect przyjmuje callback, który jest wywoływany po zakończeniu renderowania przez Angular
constructor() {
    afterRenderEffect(() => {
      console.log(
        'afterRenderEffect => logs when the application finishes rendering',
      );
    });
  }
Jeśli callback zależy od sygnału, zostanie również wywołany za każdym razem, gdy wartość tego sygnału się zmieni.
afterRenderEffect jest szczególnie przydatny do manipulacji DOM, ponieważ zapewnia różne fazy wykonywania, które pomagają optymalizować wydajność i zapobiegać layout thrashing.
Kolejność faz wykonywania jest następująca:
- earlyRead – służy do odczytu właściwości DOM przed jakimikolwiek operacjami zapisu.
- write – służy do modyfikacji właściwości DOM.
- mixedReadWrite – używane w przypadkach, gdy operacje odczytu i zapisu do DOM muszą być wykonane razem, a ich rozdzielenie na osobne fazy nie jest możliwe.
- read – służy do odczytu właściwości DOM po operacjach zapisu.
 afterRenderEffect({
      earlyRead: () => {
        return 'value - 1';
      },
      write: (value) => {
        console.log(value()); // logs value - 1

        return 'value - 2';
      },
      mixedReadWrite: (value) => {
        console.log(value()); // logs value - 2

        return 'value - 3';
      },
      read: (value) => {
        console.log(value()); // logs value - 3
      },
    });
Każda faza, z wyjątkiem earlyRead, otrzymuje jako argument wartość zwróconą przez poprzednią fazę. Oznacza to, że wynik jednej fazy staje się wejściem dla następnej. Na przykład, jeśli earlyRead zwróci ‘value -1’, to faza write otrzyma ten właśnie wynik jako swój argument.
Warto również zrozumieć, że argument sygnału działa jak zależność. Podobnie jak w przypadku sygnałów, jeśli wartość sygnału pozostaje taka sama jak w poprzednim wykonaniu, dana faza nie zostanie uruchomiona. Dzięki temu unikamy zbędnych operacji na DOM i poprawiamy wydajność.
Przyjrzyjmy się teraz przykładowemu kodowi, aby zobaczyć, jak przebiega wykonanie:
signalSource = signal<string>('initial value');

afterRenderEffect({
   earlyRead: () => {
     const value = this.signalSource();
     console.log(`earlyRead => ${value}`);

     return value;
   },
   write: (value) => {
     console.log(`write => ${value()}`);

     if (value() === 'updated_value_2') {
       return 'updated_value_';
     }
     return value();
   },
   mixedReadWrite: (value) => {
     console.log(`mixedReadWrite => ${value()}`);
     return value();
   },
   read: (value) => {
     console.log(`read => ${value()}`);
   },
 });

 setTimeout(() => {
   this.signalSource.set('updated_value_');
 }, 1000);

 setTimeout(() => {
   this.signalSource.set('updated_value_2');
 }, 2000);

 setTimeout(() => {
   this.signalSource.set('updated_value_3');
 }, 3000);
Zobaczmy, jakie dane ten kod wypisze w konsoli.
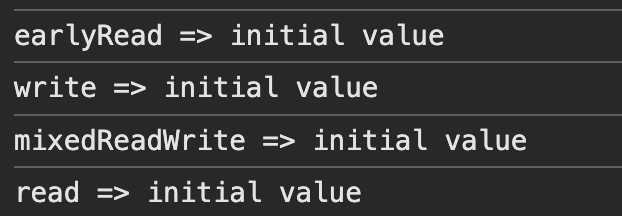
Ponieważ afterRenderEffect uruchamia się po zakończeniu renderowania aplikacji, pierwsze wykonanie przejdzie przez każdą fazę sekwencyjnie, korzystając z wartości początkowej.
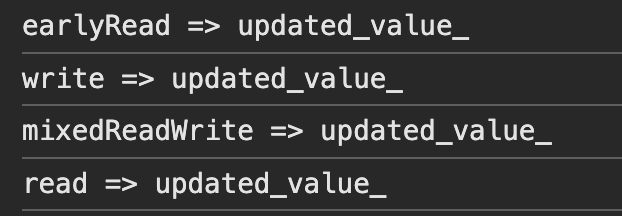
Podczas drugiego wykonania każda faza zostanie uruchomiona, ponieważ wartość w każdej fazie nie jest równa wartości z poprzedniego wykonania („initial value” != „update_value_”).
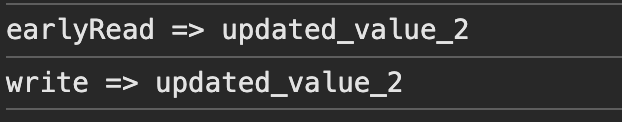
Podczas trzeciego wykonania uruchomione zostaną tylko fazy earlyRead i write. Jeśli zwrócisz uwagę na kod, w fazie write zwracamy wartość “updated_value_”, gdy wartość sygnału wejściowego jest równa “updated_value_2”.
W rezultacie faza mixedReadWrite nie zostanie uruchomiona, ponieważ poprzednia wartość sygnału jest równa jego bieżącej wartości (“updated_value_” === “updated_value_”).
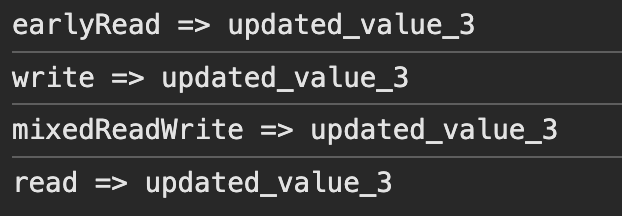
Podczas czwartego wykonania każda faza zostanie uruchomiona, ponieważ wartość w każdej fazie nie jest równa wartości z poprzedniego wykonania.
Dodatkowo możemy zdefiniować funkcję czyszczącą, która zostanie wykonana, gdy jakikolwiek zależny sygnał ulegnie zmianie.
afterRenderEffect({
   earlyRead: (onCleanup) => {
     onCleanup(() => {
       console.log('earlyRead => callback');
     });

     // Code removed for brevity
   },
   write: (value, onCleanup) => {
     onCleanup(() => {
       console.log('write => callback');
     });

     // Code removed for brevity
   },
   mixedReadWrite: (value, onCleanup) => {
     onCleanup(() => {
       console.log('mixedReadWrite => callback');
     });

     // Code removed for brevity
   },
   read: (value, onCleanup) => {
     onCleanup(() => {
       console.log('read => callback');
     });
     // Code removed for brevity
   },
 });
Aby zilustrować praktyczne zastosowanie tego hooka, przyjrzyjmy się kilku przypadkom użycia.
Przypadek użycia – Scroll na elemencie
Rozważmy scenariusz, w którym mamy listę produktów. Po kliknięciu przycisku sekcja z szczegółami wybranego produktu zostaje wyświetlona poniżej listy. Gdy sekcja szczegółów zostanie wyrenderowana, chcemy automatycznie przewinąć do niej.
Interfejs użytkownika wygląda następująco:
Ta implementacja wymaga dwóch oddzielnych faz: najpierw odczytania przesunięcia elementu (read), a następnie zastosowania przewijania (write).
readonly hiddenSection = viewChild('hiddenSection', { read: ElementRef });

 constructor() {
   afterRenderEffect({
     earlyRead: () => {
       return this.hiddenSection()?.nativeElement.offsetTop || 0;
     },
     write: (scrollingPosition) => {
       window.scrollBy({ behavior: 'smooth', top: scrollingPosition() });
     },
   });
 }
Zwróć uwagę, że używamy dwóch oddzielnych faz, a wartość zwrócona przez earlyRead jest przekazywana jako argument do fazy write.
Możesz teraz pomyśleć: „Czy nie moglibyśmy po prostu użyć zwykłego effect lub afterRenderEffect bez tych wszystkich oddzielnych faz?” – i miałbyś rację! W tak prostym przypadku jest to jak najbardziej możliwe.
Jednak to rozwiązanie jest zbyt banalne, aby faktycznie pokazać przyspieszenie działania wynikające z użycia wyraźnie rozdzielonych faz.
Aby w pełni zrozumieć ich wartość, przeanalizujmy scenariusz layout thrashing. Dzięki temu zobaczymy, dlaczego oddzielanie operacji odczytu i zapisu jest tak istotne.
Przypadek użycia – layout thrashing
Stworzymy prosty interfejs użytkownika z trzema polami i dynamicznie będziemy aktualizować ich szerokość losowymi wartościami.
component.html
<div #container>
  <div #box class="box"></div>
  <div #box class="box"></div>
  <div #box class="box"></div>
</div>
component.ts
boxes = viewChildren('box', { read: ElementRef });

for (let i = 0; i < 100; i++) {
   this.boxes()!.forEach((box) => {
     box.nativeElement.style.width = Math.random() * 200 + 'px';
   });
 }
Każde pole otrzymuje losowo wygenerowaną szerokość, a proces ten jest wykonywany 100 razy, aby uwidocznić wpływ na wydajność.
Tak wygląda interfejs użytkownika:
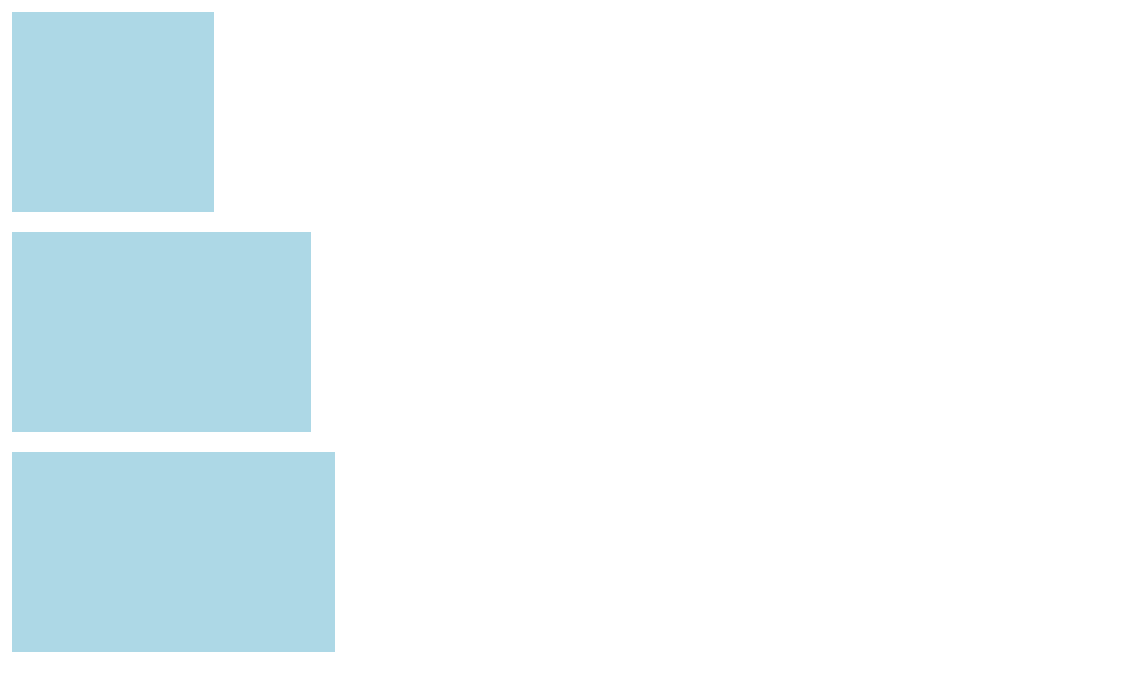
Teraz, gdy wprowadziliśmy te zmiany, przeanalizujmy uzyskaną wydajność za pomocą narzędzi deweloperskich przeglądarki.
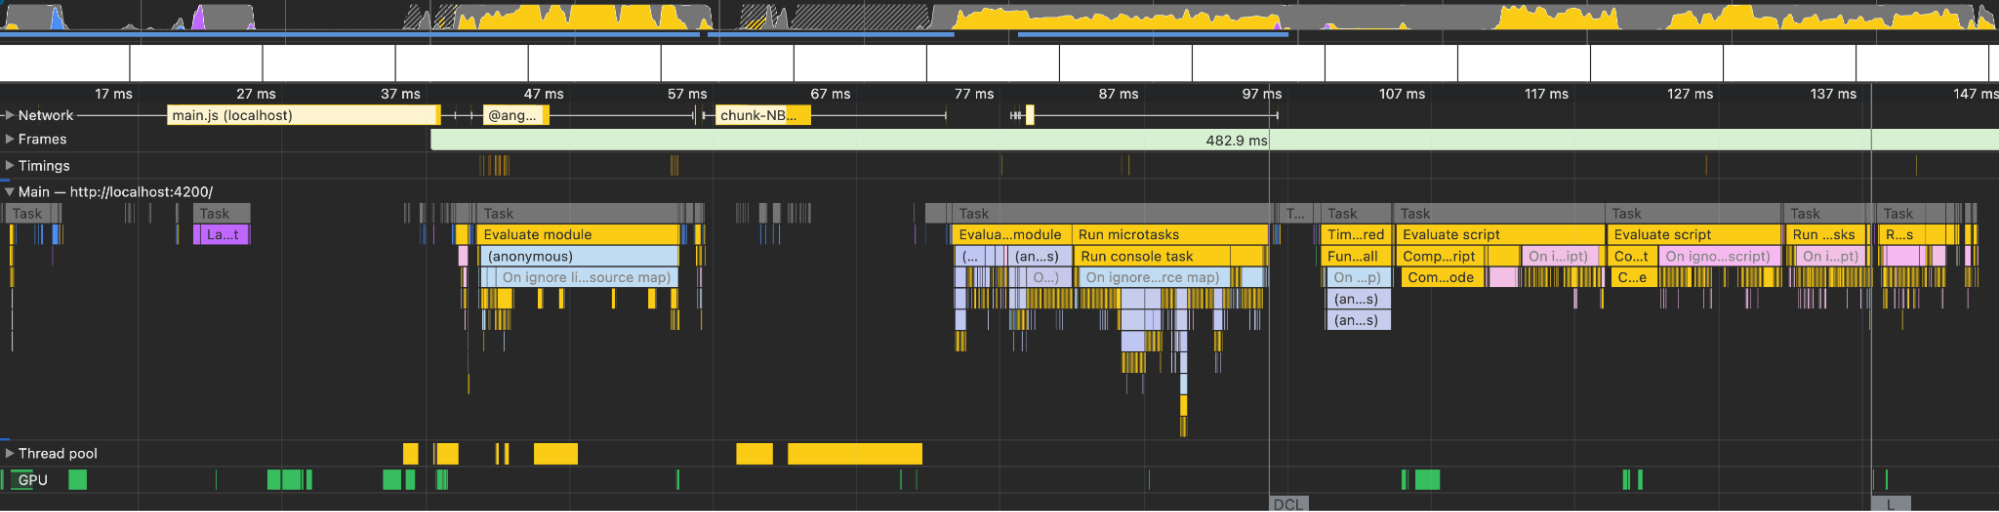
Podczas dynamicznej zmiany szerokości elementów przeglądarka optymalizuje proces. Zastosuje wszystkie zmiany szerokości i wywoła pojedynczy reflow dopiero po zakończeniu wszystkich operacji zapisu, zamiast wykonywać reflow po każdej indywidualnej zmianie.
Co się stanie, jeśli zapiszemy wartość do DOM (zmienimy szerokość) i natychmiast spróbujemy ją odczytać?
To wymusi reflow, ponieważ przeglądarka będzie musiała natychmiast obliczyć nowy układ strony.
Zapis-Odczyt
Reflowy mogą spowalniać działanie strony, dlatego przeglądarki starają się je optymalizować, grupując zmiany szerokości.
Ale jest pewien haczyk: jeśli zmienisz szerokość elementu, a zaraz potem zapytasz przeglądarkę: „Hej, jaka jest teraz ta szerokość?”, przeglądarka odpowie:
„Ups, jeszcze nie zaktualizowałem układu! Muszę to zrobić teraz.”
W efekcie wymusi natychmiastowe przeliczenie geometrii strony, co może prowadzić do spadku wydajności.
  for (let i = 0; i < 100; i++) {
      this.boxes()!.forEach((box) => {
        // Change a style that affects layout:
        box.nativeElement.style.width = Math.random() * 200 + 'px';
        // Immediately read a style that depends on layout:
        const width = box.nativeElement.offsetWidth; // This forces layout!
        console.log(width);
      });
    }
Tak wygląda analizator wydajności:
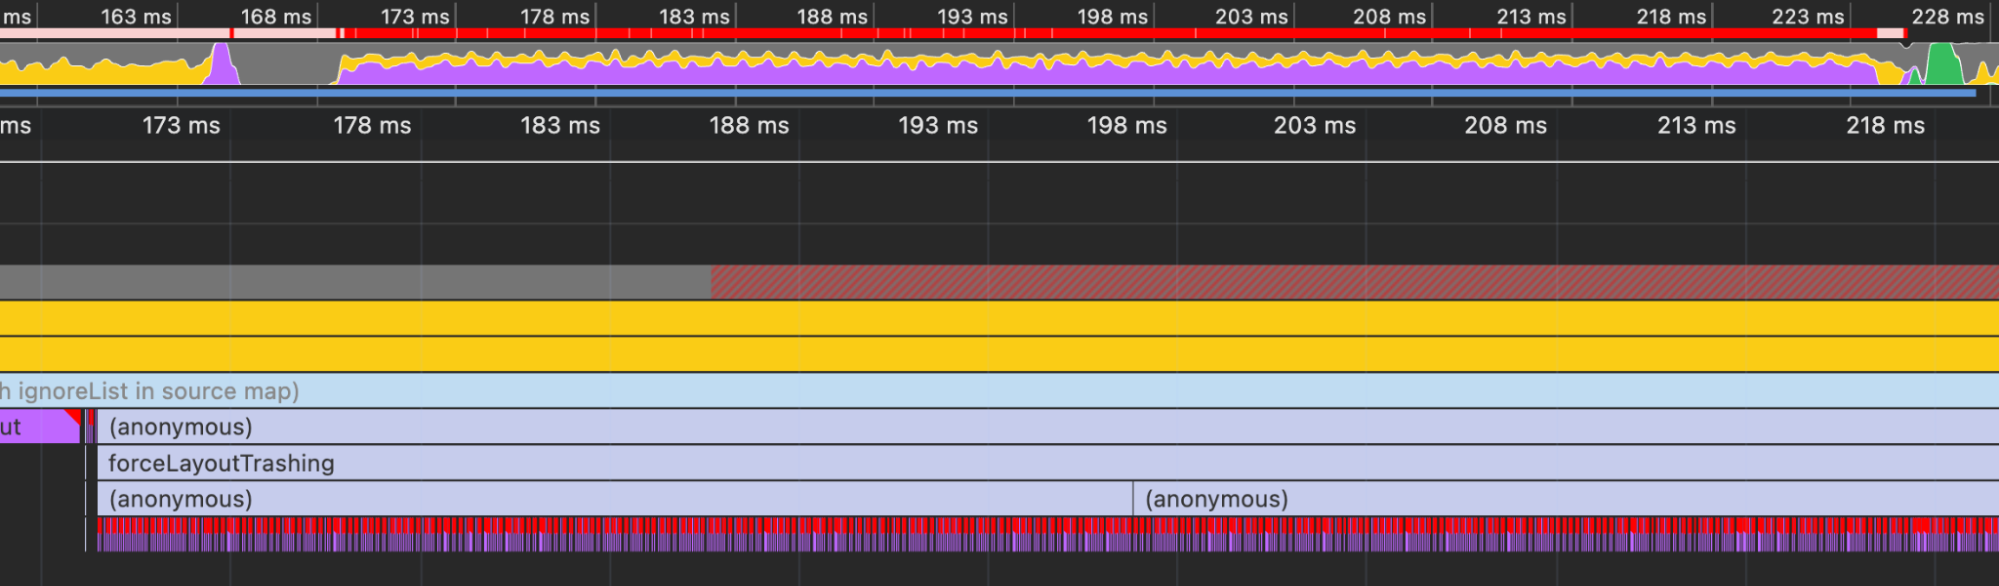
Wykres, wypełniony czerwonymi trójkątami i fioletowymi obszarami reflow, wyraźnie wskazuje na poważne problemy z wydajnością.
Aby to poprawić, musimy rozdzielić operacje na DOM na oddzielne fazy zapisu i odczytu.
Grupowanie operacji zapisu i odczytu
Aby naprawić layout thrashing, powinniśmy oddzielić operacje zapisu od operacji odczytu.
 for (let i = 0; i < 100; i++) {
    this.boxes()!.forEach((box) => {
      box.nativeElement.style.width = Math.random() * 200 + 'px';
    });

    this.boxes()!.forEach((box) => {
      const width = box.nativeElement.offsetWidth;
      console.log(width);
    });
  }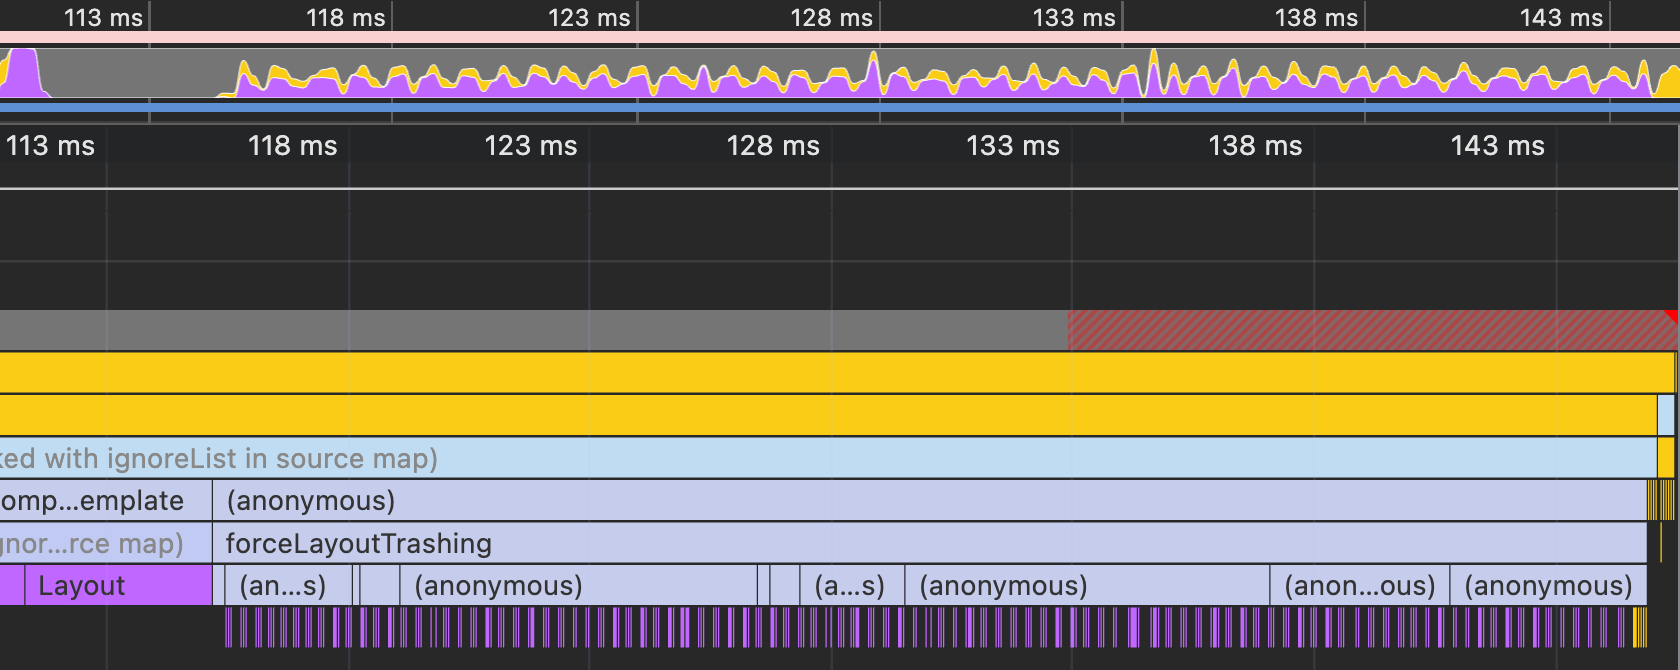
Wydajność wydaje się lepsza, ale nadal nie jest idealna.
W końcu zastosujmy hook afterRenderEffect
afterRenderEffect({
      write: () => {
        for (let i = 0; i < 100; i++) {
          this.boxes().forEach((box) => {
            box.nativeElement.style.width = Math.random() * 200 + 'px';
          });
        }
      },
      read: () => {
        for (let i = 0; i < 100; i++) {
          this.boxes()!.forEach((box) => {
            const width = box.nativeElement.offsetWidth; // This forces layout!
            console.log(width);
          });
        }
      },
    });
Tak wygląda analizator wydajności:
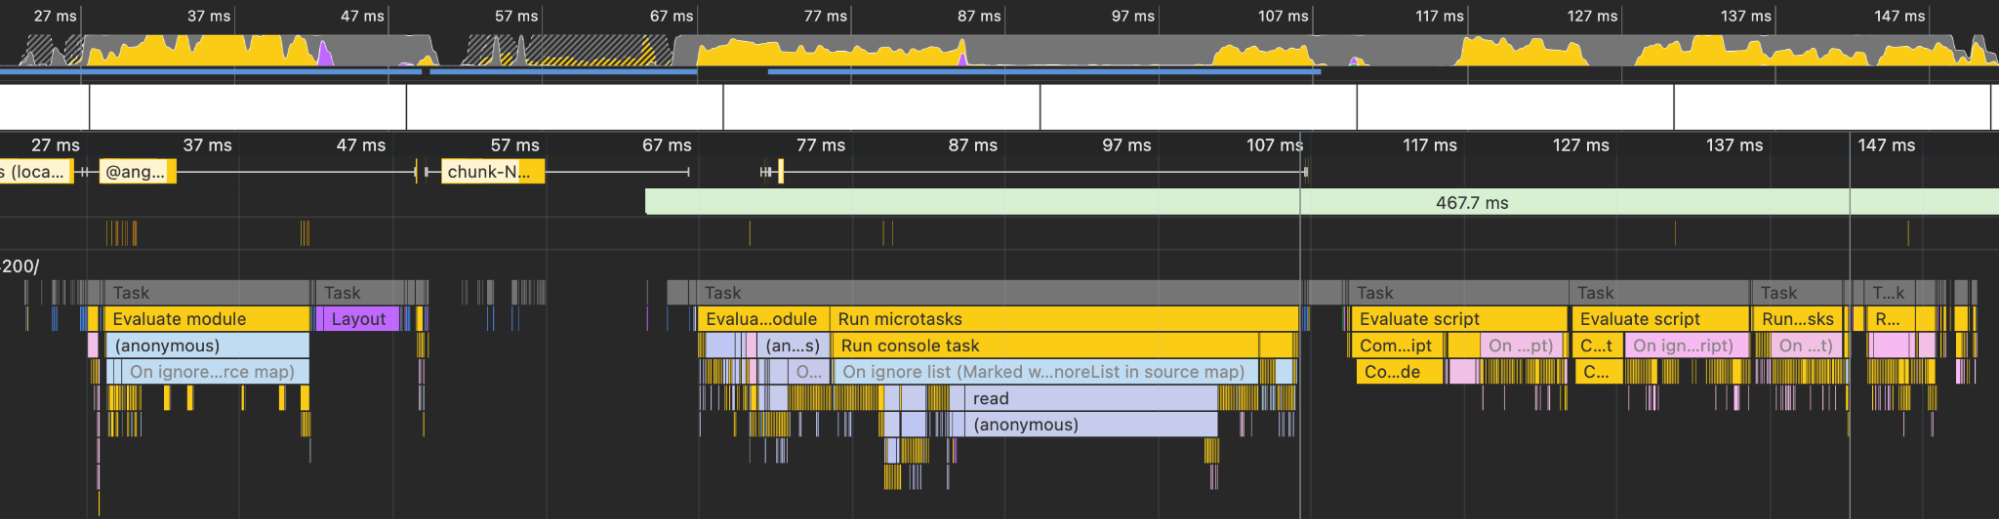
Podsumowując, Hook afterRenderEffect zapewnia optymalną wydajność, umożliwiając przeglądarce zakończenie każdej fazy przed przejściem do następnej.
Dziękuję za przeczytanie! Mam nadzieję, że ten artykuł pomógł Ci lepiej zrozumieć afterRenderEffect i jego zalety w kontekście wydajności.